1018 | 今週のテックと世界:AIモデル、金の輸出、西岸の衝撃
Show notes
今週の注目ニュースを幅広くお届けします。AIモデルと開発ツールの動きから、Linuxカーネルの変化、金と太陽光で見る世界経済の転換、そして西岸の衝突や日本国籍取得の体験、さらにネタ系の「アヒルの池」まで。数字と背景をやさしく読み解きます。
タイムライン
- 00:00:04 オープニング
- 00:00:22 DeepSeek V4.1 Flash:新モデルの実力と価格
- 00:05:55 llmspeed:買う前にローカルLLMの速さを体感
- 00:09:13 ChromeとEdgeがXSLTを削除へ:何が壊れ何が壊れないか
- 00:13:04 Pele:Mermaid図を高速・テーマ対応のSVGに
- 00:15:58 esp32sim:ブラウザでESP32ファームを動かす
- 00:19:35 Linux 7.2:開発統計が映すAI時代のカーネル
- 00:24:23 金が米国最大の輸出品に:ドル離れの影?
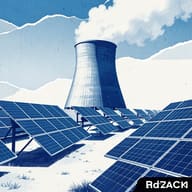
- 00:30:31 太陽光が世界で初めて原子力を超える
- 00:36:16 西岸タイベで欧州外交車列が入植者に襲撃される
- 00:39:01 日本の帰化を体験記で語る
- 00:45:38 その場で合成されるアヒルの池
- 00:49:06 OpenCode侵害:APIキー漏洩と蒸留攻撃
- 00:49:50 クロージング
関連リンク
- DeepSeek: DeepSeek v4.1 Flash 1017
- DeepSeek-v4.1-Flash-1017
- Show HN: Llmspeed – feel how fast a local LLM runs before you buy the hardware
- Chrome and Edge are removing XSLT: what breaks and what does not
- Pele – Mermaid diagrams as themeable SVG
- Show HN: Esp32sim – Run ESP32 firmware in the browser
- Development statistics for the 7.2 kernel
- Gold is now the top U.S. export
- Solar surpasses nuclear power globally for first time
- Israeli settlers attack European diplomatic cars in West Bank beat French mayor
- I Became a Citizen of Japan
- Show HN: High-quality duck audio synthesizer
- OpenCode Hacked: User credentials leaked
このエピソードは Bri によって制作されています。Bri は高度な AI 技術で、あなたが気にかけるフィードを聞くためのポッドキャストに変換します。お問い合わせは hi@bri.so まで。
Transcript
葵: どうも、ハッカーニュース・ラウンドアップ、葵です。
悠真: 悠真です。今日はこの24時間で出てきた話題を、コメント欄の議論を中心にたっぷり紹介していきます。今日は人工知能、ネットの仕組み、そして世界の構造変化まで、幅広い話題が並びました。全部つながっているんですよね。
葵: そう、どれも「変わる」をテーマにした話です。さっそく最初はAIの話から。DeepSeekがV4.1 Flash 1017というモデルを出しました。10月17日のスナップショットで、やや緩やかな更新位置づけなんですが、実態はかなり目立つ改良です。
悠真: 仕組みの説明をしましょう。5520億パラメータのスパースなMoE、つまり混合エキスパートモデルで、しかもCausal Encoder-Decoderという新しいアーキテクチャの初採用なんです。入力のときは80億パラメータ、出力のときは160億パラメータだけ有効化される非対称な構成で、これがトークンあたりの計算量を抑えている。
葵: そして注目なのがビジョンです。V4.1 Flashでは画像理解がネイティブに組み込まれていて、視覚とテキストの埋め込みが事前学習の最初から一緒に訓練されている。以前の実験モデルのように後から足したのではなく、生まれつき持っているわけですね。
悠真: コスト面も大きいです。圧縮KVキャッシングで、キャッシュメモリが前世代のFlashの4分の1程度まで削減された。エージェント系のワークロード、つまり長いやりとりを何百ステップも続ける処理では、これがコストに直結します。
葵: 料金は100万トークンあたり入力15セント、出力60セント。DeepSeekはV4.1 Flashが上位のV4 Proをパフォーマンス、速度、タスク完了時間のすべてで上回ると表明しています。しかもOpenRouterの数字だと、50パーセンタイルで152トークン毎秒、1.21秒の応答開始、3日間の稼働率100パーセントと、速くて安定している。
悠真: コミュニティの実感も上がっています。hmontazeriさんは「お気に入りのモデルがさらに良くなった」と喜んでいたし、Risphereさんは独自のWeb検索APIに注目していました。OpenAIと比べて10倍安いんですって。
葵: その検索API、後に続くコメントによるとすでに単独のAPIとしてリリースされているそうですよ。chloereiさんがリンクを出していました。ただ、中身は改善の余地があるみたいです。ytxmさんが試したところ、Microsoft製品の公式ページが見つからなかったり、ニッチなOSSパッケージを検索するとDebianのリポジトリが1位でホームページは10位以内だったりと、mixedな結果だったと。
悠真: ベンチマークの話も見ておきましょう。Hugging Faceのモデルカードでは、Terminal-Bench 4.0が前バージョンの31.2から42.3に跳ね上がり、K3やGLM 5.3、GPT-5.6 Solを上回っています。ただしOpus 5にはまだ届いていません。
葵: 一方で、そのベンチマークそのものへの懐疑もあります。freakynitさんは「こんなベンチマーク、本当にあり得るのか?」と、あの有名なパドメのミーム形式で突っ込んでいました。
悠真: そこから興味深い展開です。freakynitさんは、これらが一般に公開される最後の超ハイエンドモデル群かもしれないと予想しています。これからは最先端モデルは自社、政府、超高額契約先向けに非公開にするかもしれないと。
葵: それに対してslopinthebagさんは、Sol 6.1が安くて有能なので心配は要らないという立場。A_D_E_P_Tさんはもっと枠組みを広げて、モデルごとに得意領域が違うと指摘しました。GPT-6/6.1は3Dモデリング、GoogleのArgonは文章とGoogle連携の検索・旅程作り、AnthropicとDeepSeek、GLMはコーディングを解いている、と。
悠真: モデルをどう組み合わせるかという実践談も出ています。olavggさんはDeepSeek Flashで作業してOpus 5.5をレビューアー兼助言者にする構成だそうですが、シングルプロジェクトで200ドルのClaude Code契約を24時間以内に使い切ってしまうんですと。
葵: それはどうやって?とrpastuszakさんが質問していて、fahrvrgnugenさんの答えが「大量のMCPをロードしてまったくコンパクト化しない」でした。なるほど、コンテキストを膨らませまくっているんですね。
悠真: egeozcanさんは別の組み合わせで、Opusを計画用にAPI経由で中程度の思考で使い、残りはDeepSeekかGLM Flash、最後のレビューループにSol 6.1、全部piというツールで回す構成です。複雑なタスクでも最高10ドル程度で、サブスクリプションに匹敵する柔軟性だと。
葵: 一方で、モデルの質感には温度差があります。cromkaさんはSol 6.1について「金魚の記憶のような状態で、Opus 5と同じくらいの作業しづらさだ」と酷評していて、Opus 5.5の方がはるかに賢いと。LaurensBERさんは逆に、GLM 5.3 Flashの趣味での使用では強いモデルが必要だったのは両手で数えられるほどだと。
悠真: 大きさの話もありました。jononorさんが、GLM 5.3を超えたのは嬉しいけど、ローカルで動かせる小型Flashモデルも戻してほしいと言ったのに対し、PragmataさんはDGX Sparkを2台買えばどうかと提案しました。でもbashtoniさんは「これは小型モデルではない」と却下。Spark2台で現状最も有能に動くのはMiMo 2.6 Flashだそうです。4台なら可能かもしれないけど、V4.1はFlashとしてはかなり大きい。
葵: そしてlogicchainsさんの一歩進んだ見立てが、このままのペースで行くと、フロンティアラボはAnthropicとDeepSeekになって、OpenAIは追い上げを迫られるだろう、というもの。
悠真: この後の展開として、モデルが強くなって安くなるほど、「どのモデルか」より「どう使うか」の設計が勝負になっていく、という空気がこのスレッドにはありました。
葵: その点でぴったりつながるのが次の話です。動かせるモデルは分かった、じゃあそのモデルを動かすハードを買う前に、速度を試せないかというツールが出ました。「llmspeed」です。
悠真: 作りはシンプルで、GPUやMacを選んでモデルを選ぶと、トークン毎秒と、最初のトークンが返ってくるまでの時間を実際に体感できる。数値はr/LocalLLaMAやlocalscore.aiなどのコミュニティ計測に基づいていて、計測がないものは類似構成からの推定やスペックからの予測と、開示されています。
葵: ハードのカタログは充実していて、RTX 4090や5090、Mac StudioのM5 Ultra、AMDのRyzen AI Max+、クラウドのH100やA100まで並んでいます。モデル側はDeepSeek R1 Distill 14BやGPT-OSS 20B、Llama 3.1 8Bなど。
悠真: ただ、精度への疑問はすぐ上がりました。pilouさんは「根拠が不明だけど、私のM2 Ultra 128GBはM3 Ultra 512GBの表示速度のほぼ2倍で動く」と指摘。作者のalbinstmanさんは「どのモデル、どの量子化で試したか教えて」と検証を続けています。
葵: 機能要望もありました。bozdemirさんはモデル一覧がまだ限定的なことと、実行ハーネスのライブラリとバージョン違いで速度が変わるから、個々の構成でハーネス情報も見たいと。作者はハーネス込みのデータがベンチマーク源にないことが制約だと答えていて、bozdemirさんはStrataやQwen 3.8 Flash Nextの追加をリクエストしています。
悠真: cyanydeezさんはもう一歩踏み込んで、ハーネスがボトルネックになるのはコンテキストのプリフィルや環境の初期コストだけで、まともなハーネスなら無視できるはず、そうでないなら200kトークンものコンテキストを投げているだけではという見方でした。
葵: 個人的に好きだったのは、hbogertさんの自慢話です。2017年のRX580、VRAM 8GBでQwen 9Bモデルを動かしている。エンジンはLM Studio、上でopencodeを走らせ、生成20トークン毎秒。ベンチには勝てないけど、手元のKubernetesクラスタのトラブルシュートに回すのは十分快適と。
悠真: ただしプリフィルが100から200トークン毎秒程度で、長い質問や、数千トークンから始まるopencodeのようなハーネスでは最初が遅い。でもキャッシュが暖まればかなり心地よい、と。
葵: そして merbanan さんの追伸が面白い。RTX 2060 Superの8GBに64GBのRAMでも、Qwen 3.8 Flash Nextが実用速度で動くと。ここ2週間でStrata関連の速度改善が続いたそうです。
悠真: このやりとりで良いなと思ったのは、「これはコーディングに使えるの?」と聞くinternet_pointsさんへの答えで、hbogertさんが、大掛かりなアーキテクチャのリファクタをワンショットでやるのは無理でも、細かいリファクタや、CUEのような言語でLSPのリファクタが弱いところを補うのに使えていると。加えて、メール分類や家庭内音声コマンドのような、さじ加減の「十分良ければ」用途が広がるだろうと。
葵: つまりllmspeedの話は、DeepSeekのような強力なモデルを「事前に試す」ニーズと、古いハードで実用に足りる速度が出るという現実の両方が語られていたスレッドでした。
悠真: よし、ここから話題を転換します。AIではなく、ウェブそのものが消す話題へ。ChromeとEdgeがXSLTを取り除こうとしています。XSLTというのは、XMLを別の形、たとえば人間用のHTMLに変換する古い仕組みです。
葵: まずここで皮肉な話を一つ。この記事自体が、アクセス集中で503エラーを返して死んでいました。Hacker Newsの読者がそのままメタコメントを連発していて、Insimwytimさんが「このサイトが壊れるのは分かっていた」、Barbingさんが「doctor-seo dot net が我々を見捨てた。これはもう何という世の中だ」と。
悠真: 幸い、g-b-rさんがInternet Archiveのリンクを貼っていて、Aachenさんが「単一のサイトが来たトラフィックを耐えられなかった一方、アーカイブが今落ちているものを帯域十分に配る第二のコピーを持っていてくれて感謝しかない」と絵に描いたようなネット文化談義をしていました。
葵: 記事の内容は、EdgeがChromeと一緒にXSLTを消すというもの。pjmlpさんが一言「EdgeはChromeだ」とまとめていましたが、zamadatixさんが補足したのが本質です。記事冒頭にも書いてあり、Microsoftは別途この機能を引き継ぐ意向がないこと、そしてMicrosoftページからの引用として、「機能と互換性のため、EdgeはChromiumのウェブプラットフォーム変更のほぼすべてを採用する。ただしMicrosoftはEdgeの完全なコントロールを保持し、変更を遅延させたり拒否したりできる」とあることを紹介。削除のタイミングは常に一緒ではないとも。
悠真: XSLTに時代を感じる読者もいましたが、Trustable8さんの追憶が一番情緒的でした。XHTML時代には、XSLTはサイトを部品化する希望の仕様だったと。彼はJavaScriptがjQueryなしではまともに使えなかった時代に、XSLTで別々のコンポーネントをマージする初期のウェブサイト作成ツールを作っていて、それは本当に強力だったそうです。ただ、XHTMLがHTML5に取って代わられ、XSLTはほぼ無用に。それでもここまで生き残ったのは、主にXMLファイルのスタイリング用として維持されていたからだと推測しています。
葵: そのXHTML採用の決定に対して、wahernさんの考察が深い。HTML5がさらに一歩進めて、正規のXMLまたはXML互換のDOMエンコーディングを定義してくれればよかったのに、反XMLの感情が明示的で、かつ意地悪だったと。ただ、人気のXSLTプロセッサはHTML5の読み書きができるし、彼自身、XSLTが死に筋だと確定した後で回り道をして戻ってきたそうです。良い道具は良い道具。放置されているのに使い続けられることは、それが本物だという証明だと。
悠真: 言語としての評価も分かれています。g-b-rさんはXSLT 1.0の仕様は書き方が悪く、理解に苦労したと。WCSTombsさんがそれに続けて、XSLT 1.0には明白な過ちがいくつもあり、誰も素のXSLT 1.0だけを実装していないと。実際はXSLT 1.0の大部分にEXSLTという非公式拡張を足したものが最小限として機能している。そしてXSLTの仕様は2.0と3.0に進化したけれど、完全なオープンソース実装は今日までない、と。
葵: そしてこの削除を技術的に語るのはtroupoさんです。彼はWHATWGのHTMLリポジトリに上がっている、XSLT削除の長い議論を紹介していて、その提案はdoriantaylorさんのswetというもので、「プラットフォーム」が推し進めようとしているどのテンプレーティング提案よりもすでに良い、と評価しています。
悠真: つまり、標準の一部が消えることへの不安と、それを置き換える新しい軽量な仕組みへの期待が、両方ある状態なんです。
葵: それでは、その「軽量な代替」というテーマに続きます。Peleというライブラリの話です。Mermaidの図を、CSS変数でテーマ化できるSVGにレンダリングするオープンソースのライブラリです。
悠真: スペックが目を引きます。依存関係ゼロ、バンドルサイズはgzipで230KBとMermaid.jsの1.6MBの約6分の1。レンダリングは0.05〜0.3ミリ秒で、Mermaid.jsの6〜82ミリ秒と比べ最大500倍速い。Mermaid 12.1.0に組み込まれている全ダイアグラムタイプをサポートしています。
葵: Obsidianのために開発されたのが背景で、図を速くレンダリングしてテーマに合わせるためだそうです。MITライセンス、火山と火の女神ペレにちなんでいます。
悠真: ここで読者の核心的な評価に移りましょう。nickmainさんが「公式のMermaidライブラリはまだレイアウトのためにフルまたはヘッドレスのブラウザ環境が必要なのか?それなら、他の場所でMermaidレンダリングを埋め込む人にとっては大きな朗報だ」と指摘しました。
葵: そしてinvokestaticさんが実体験を述べています。PythonのmermaidxライブラリはCI/CDでドキュメントに図を埋め込むのに使えているけれど、レイアウトが時々ガタガタになる、接続がクロスしてしまうのに設定を変えても直らず、結局mmdcでエクスポートしたPNGを埋めることにしたと。falsaberN1さんは、SVGを出力するMermanというGitHub上のプロジェクトも教えてくれました。
悠真: 一方で、ルークはもっと率直です。lukeifyさんは「Mermaidを複雑なことに使おうとすると、いつも不条理で位相的に貧弱なレイアウトにへとへとになる。スタイリングの問題は些細なことだ」と。そしてtptacekさんが、グラフのレイアウトは昔から難しい問題だと一言。
葵: mcapodiciさんの考察が詩的でした。レイアウトは文章を書くのに似ているのかもしれない。よく伝わる図を作るには、問題をきちんと解けている必要がある、と。thegagneさんは、D2とELKやDagreを使うとうまくいくことがある、ELKに深く入れば多くのことができる、と補足しました。
悠真: ソースの所在も少しドラマがあって、Imustaskforhelpさんが「オープンソースか?GitHubのリンクが見つからない」と書いたところ、自分で見つけて obsidianmd/pele というURLを追記。blktigerさんも同じリンクに先着していたという感じで、「オープンソースならGitHubのアイコンをページの上に置いてほしい」というアドバイスも併せていました。
葵: 名前の話も国際的です。druviscさんが、ペレはラトビア語で「ネズミ」だと。hmokiguessさんはポルトガル語では「皮膚」。apodikさんが続けて、ブラジルではサッカー選手だ、と。
悠真: XSLTの削除とこのPele、対比がきれいでしたね。プラットフォームが標準を消す動きと、コミュニティが軽量なライブラリで隙間を埋める動き。
葵: そういう隙間を埋める動きは、ハードウェアの世界にもあります。esp32simという、ブラウザでESP32のファームウェアを走らせるオープンソースのエミュレータです。作者のjoakimerikssonさんによるShow HNでした。
悠真: 技術的な要点を押さえると、Rust製で、4つのESP32 SoCを命令レベルでエミュレートします。Espressifの2つのCPUアーキテクチャ、つまりXtensaとRISC-Vの両方をカバーしている。そして重要なのは、本物のマスクROM、本物の2段目のブートローダー、修正されていないアプリイメージをそのまま起動する点です。パッチを当てたファームウェアも、邪魔なスタブもない。
葵: 対応SoCは、XtensaのESP32-S3とRISC-VのESP32-C3、C6、そしてクラシックなESP32。クラシックのESP32はデュアルLX6コアでECO3 ROMを起動し、GPIO、UART、タイマーを持ちます。ボードオプションとしてLilyGOのTTGO T-Displayも追加可能。デコーダの検証も徹底していて、S3では97万7000命令、不一致ゼロと報告されています。
悠真: 使い道として期待されているのは、IoTプロジェクトでの活用です。raminfさんが実務の観点から述べていました。IoTではハードウェアの「機能的な」ソフトシミュレータを作ることが多い、それはBLEやWiFiやAPIコマンドをエミュレートするレベルのもの。ハードが来たら、そのシミュレータはCI/CDテストで使われるだけに落ち着く。ここで欲しいのは、機能シミュレータの代わりに、本物のファームウェアをモバイルやバックエンドの各開発者、CI/CDランナーごとに走らせることだ、と。
葵: そのシミュレーションがエミュレーションなら、本物のCコードが本物の命令に沿って動くということです。mrtksnさんがここで綺麗な実例を出しました。彼はドローンシミュレータをvibeコーディングして、ESP32をブラウザでシミュレートし、実際の飛行制御のCコードがWebAssemblyとして走るようにしたと。ドローンが本物のESP32フライトコントローラで飛んでいて、本物のESP32ボードにも直接フラッシュできるんですと。
悠真: さて、この投稿のコメント欄には、もう一つのテーマがありました。READMEの話です。
葵: dofmさんが率直に、「遊んでみたい。だけど、あの巨大で整形が下手なAI風の段落が多すぎる。特にボードのセクションのあれ。中年になった素人だが、あれは若い専門家読者でさえ疲れると思う。このページの見せ方を再考してほしい」と。
悠真: rvzさんがさらに強く、「READMEがDONTREADMEになる条件は、小説のような長さ、整形の下手さ、一文ごとにいくつものclaudismsが入ること。読み手が読まないし、作者自身も読んでいないだろう。コード品質の話をしていた人たちも消えてしまって、slopの予兆になる」と。
葵: exe34さんが一言で「これはテーブルにすべきだった」と。tyromaniacさんが「これはvibeコーディングだ」と指摘したのに対し、crazysimさんが「OSSで無料だ」と軽く反論。the__alchemistさんは「Show HNの多くに同じ批判ができる」と、この手の質問を幅広く下げる発言もありました。
悠真: 品質の議論はさておき、turbine401さんが出した質問は妥当なところで、「Wokwi.comとどう違う?彼らは何年もやっていて、多くのマイコンをエミュレートしている」と。WalterGRさんが読みやすいリンクを張り直していました。
葵: 作者が一番聞きたいとコメントで書いていたのは、組み込み開発者からのフィードバック、つまり開発、テスト、CIで実際に使うために、このエミュレータに何が足りなければいけないか、です。
悠真: そしてこの話から自然に繋がるのが、オープンソース開発そのものがどう変わりつつあるかという話です。LWNのLinux 7.2カーネルの開発統計です。
葵: 数字から始めましょう。Torvaldsさんが8月17日に7.2カーネルをリリースした際、修正の流入が「望んでいたより多い」と述べていました。7.2はマージコミットを除くコミットが1万6418で、前の7.1を上回り、歴代2位の開発サイクルです。6.7が歴代1位ですが、あれはbcachefsの開発履歴の一括マージが主因で、7.2の量はもっと広い分野に及んでいます。
悠真: コントリビュータは2652人。前の記録、7.1の2479人から大きく増えています。Git時代以来の推移を見ると、リリースごとの開発者数は明確に右肩上がりで、ただその傾きが変わった、つまり最近の増加速度が顕著に上がっているという指摘です。
葵: コミット数の上位はUwe Kleine-Königの151、ドライバのクリーンアップ中心。次のRosen Penevの146は、特に注目で、アーキテクチャ固有、ドライバ、ネットワーク、暗号などのサブシステムで、LLMが書いたバグ修正を長く続けていたそうです。
悠真: 行数の上位はまた別の顔ぶれで、Matthew Stewartが83万5878行で1位。LWNによれば、これはAMDのGPUドライバに、機械生成の巨大なヘッダファイルを足すという伝統に従った結果だそうです。Hawking Zhangも同じことをして2位。
葵: そしてLinuxに馴染みのある人にはおなじみのMiguel Ojedaが3位の3万8979行。Rustのzerocrate、zerocopy crateをカーネルソースに持ち込みました。
悠真: ここからが本題の「AIとLinux」の交差点です。タグの統計で、Tested-byがコミットの8%強、Reviewed-byが48%。Reviewed-byは最近、ゆるやかな減少傾向にあり、LWNは、これが実際のレビュー量の減少を反映しているのかはさっぱり分からないと慎重です。
葵: そして記事の最後の段落がこのスレッドの火種です。05kqhgさんが指摘した通り、そこには「Linuxカーネルは研究や実験のためではなく本番使用のためのものだ。しかし今、カーネルの開発プロセスとコミュニティの上で、大規模な実験が行われている」と書かれていて、mh-さんがその次の一文を引用して補足しました。「このコミュニティは35年の歴史の中で新しいプロセスとツールを何度も吸収してきた。今回はそうしないというのはまずあり得ない。ただ、その吸収は必ずしも円滑ではなかった」と。
悠真: コメント欄での対立軸を見ていくと、Matlさんは理論上は良いとしても、カーネルやOSS全般が今、slopパッチとPRに囲まれていて、しばしば応答するのはエージェントだけだという現実を指摘しました。「外からの寄付を開きたくなくなる」と。
葵: 一方でdist-epochさんは一言で反対側に立っています。「プロジェクトのバグが修正されるなら、どこから来たかを気にするか?人間だけの寄付が欲しいか?Linusはバグが直されることを望んでいる」と。
悠真: このLinusの立場には、リンクで繋がる背景があります。mathisfun123さんが、Linusの自分の感情を示すメーリングリストのリンクを添えて、slopの話は大きく誇張されていると主張。senderistaさんは反対に、「LLMツールの使用が理解や能力と相関しないというLinusの主張は、馬鹿げている」と断言。
葵: そこへrvzさんが、Linus自身の事例を出してきて、この議論を一段深くしました。LinusはClaude Codeでパッチを書き、データ競合のバグをカーネルに入れ込んだが、本人は気づかず、他のレビューアが新しいカーネルリリース前に発見した、と。rvzさんは「Linus自身が、Claudeが自分のコードに何をしたのか理解していないようだ。slopパッチについて他者を警告していたのに、いざ自分が使うと怒りを向けられる他者への当たり方が変わっている」と。
悠真: そしてperspectivalに近い見方をpelagicAustralさんとnvme0n1p1さんとnomelさんが展開しました。pelagicAustralさんは、LinusがAIをこれほど摩擦なく受け入れるとは思いもしなかった、ただRustのカーネル取り込みの後のことだから、賭けに勝っていたかもしれないと。nvme0n1p1さんは、Linusは前向きで、それがLinuxが数十年も関連し続けてきた理由だと。nomelさんは、なぜ驚くのか、彼は実用的な人で、関心事は正しさと品質だけだったはずだ、と。
葵: mycallさんの補足が締めくくりです。Rustは成熟に長い時間がかかって初めて考慮されるようになった。AIは速いが、より容易に統合できる、と。
悠真: 続けて、AIのモデルではなく、AIと金が関わる経済の構造変化に移りましょう。Numismatic Newsの記事です。「金が今、米国の第一位の輸出品である」と。
葵: 記事の内容はこうです。普段は米国の輸出額の上位は、石油、医薬品、あるいは航空機とその部品。しかし2025年10月以降、ほぼ毎月、金の輸出額が他のどのカテゴリよりも高くなっています。価格が史上最高値を更新しているためだけではありません。2026年2月には、輸出された金のトン数も史上最高記録の可能性があります。
悠真: 行き先が特徴的です。最も多いのはスイスで、ほぼ確実にスイスの精錬業者向け。次に香港、これは中国向けの金の世界的な入口。第三位がイギリスで、ここにはLBMA、つまりLondon Bullion Market Associationが置かれています。
葵: 政府は金備蓄の変化を報告していないので、これらの輸出は鉱山の産出とリサイクルから来ていると見られる、と記事は書いています。
悠真: そして、なぜこうなっているのか、公式の説明はないと、記事の書き手Heller氏は明記した上で、自分の推測として5つ並べています。1つ目は、複数の外国政府が米ドルの購買力喪失への警戒を強め、別の準備資産を求めていること。外国の中央銀行の金保有の総額が、米国債の保有をすでに上回っています。2つ目は、ほとんどの国は米国と交渉する経済的・金融的な力がなく、ドル以外での支払いを求められないこと。3つ目は、中国は経済的・金融的な力を持ち、金での支払いを求められること。中国の中央銀行は過去数年、米国債の保有を減らしていて、2021年4月の1兆960億ドルから2025年2月の7843億ドル、そして2026年2月の6933億ドルまで減っていて、その減少分を金で置き換えているそうです。
葵: 4つ目は、中国政府が代替決済システムや、BRICS諸国間の「ユニット」という通貨の推進で、国際商取引でのドル使用を減らそうとしていること。5つ目は、中国中央銀行の保有金に、中国の主権投資ファンド、軍、国営企業の在庫、民間の保有まで加えると、中国政府は実質的にどの政府よりも多くの金をコントロールしていると見るアナリストがいること。この推測の核心は、米国の金輸出のかなりの割合が中国に行っている、ただしその多くはまずスイスの精錬所を経由してkgバーに変換されると。そして、政府が他の政治的譲歩と引き換えにこの形での支払いを黙認している可能性もある、と。証明はできないが、他の説明よりはるかに筋が通っていると結んでいます。
悠真: ただ、この記事自体への疑いがコメント欄では強いんです。EA-3167さんが冒頭から「記事の真偽を疑う」と切り出し、元の金属輸出の話では、金を含む米国の金属輸出は年半ばで3位だったと、複数のリンクを張りながら主張しました。
葵: thisisthenewmeさんが、それを検証した結果、EA-3167さんが貼ったリンクのひとつは参照がなく、LLM風の文面を持つサイトのようだが、元記事はbea.gov、つまり米国商務省経済分析局のデータに基づいている、と反対側から指摘しました。
悠真: ceejayozさんはそのEA-3167さんに「なんでこの記事だけを信頼するの?」とリンクで問いかけ。iAMkenoughさんはもう一歩踏み込んで、EA-3167さんが挙げた3つのソース自体、聞いたことのない出版物ばかりで、credibilityが独立に検証できない、と指摘しました。TradeIntはSamsungが信頼していると広告しているが、SamsungがTradeIntを使った記録は見つからない。Product Huntの5つ星評価は、作成者がサービス開始時にアカウントを作って以来活動がない1人の人が作ったもの。すべてブログスパムに見えると。「誰でも、あるいはAIなら、何でも発信できる。それらのリンクがなぜ共有する価値があるの?」という問いが一番刺さったと思います。
葵: そしてこのスレッドの外側でも、XCSmeさんの一言から始まる別の議論が走りました。XCSmeさんは「金じゃなくて、トークンだと思っていた」と。
悠真: Aachenさんがそれに乗って、「私なら広告と取引手数料だと思っていた。でも記事には通常は石油、医薬品、航空機と書いてある」と。Aachenさんは医薬品について「他の場所で作った方が安そうなのに」と驚き、航空機について「世界はどれだけ航空機を必要とするのか」と問いました。
葵: そこへの回答が充実しています。cpgxiiiさんが、旅客機と軍用機は高価であり、ボーイングとロッキード・マーティンのほぼ全生産能力と、GEとP&Wのエンジン生産能力が、何年も先まで予約されていると。さらに、エアバスが世界中に最終組み立て工場を持つのに対し、ボーイングは米国でしか最終組み立てをしないと。
悠真: graemepさんが医薬品を補足しました。特許期間中の医薬品は特許切れのものよりはるかに高く、金額としては総量の割に大きい。製造コストは重要ではない、と。
葵: michaeltさんが、Aachenさんの「どれだけ航空機を」という問いをより広い観点で覆しました。アメリカ企業が極東だけで製造している場合、ヨーロッパの人がAppleやNVIDIAやNikeやLevi'sの製品を買っても、それはアメリカの輸出ではなく、インドネシア、中国、ベトナム、台湾、あるいはそのどこかの輸出だ。ただアメリカは利益は得ている、と。
悠真: JumpCrisscrossさんの整理も大事です。「物品かサービスか。アメリカでは輸出という言葉を前者だけに使う慣習があり、それが時代錯誤だ」と。
葵: 一方で、トークン派のXCSmeさんがもう一歩進めて、「市場の時価総額を考えれば分かるのでは?」と。何兆ドルもの価値がついたAI企業が多いからと。WJWさんの答えが冷ややかで、「AI企業が合理的に評価されていれば、そうなるだろう。実際はそうではない」と。
悠真: ここまでの金と通貨、経済の話題の流れから、次はエネルギーの話に自然に繋げましょう。pv magazineの記事です。太陽光発電が、世界で初めて原子力発電を超えました。
葵: WNISR 2026、World Nuclear Industry Status Reportによると、2025年に太陽光発電の発電量が初めて原子力の年間発電量を超えました。そしてより詳細には、2025年3月に風力発電が月間ベースで原子力を超え、4月に太陽光が超えました。2025年3月から2026年6月までの間は、太陽光か風力のどちらかが毎月、原子力より多く発電しています。さらに2026年3月、4月、5月には、両方が同時に原子力を超えました。
悠真: 容量の差はさらに大きく、太陽光は2025年に510ギロワット増えて2383ギロワット、前年比27%増。風力は159ギロワット増えて1291ギロワット、14%増。原子力は1.5ギロワット増の399.5ギロワットで、稼働中の容量は0.5ギロワット減の368.6ギロワット。原子力は25年以上、基本的に横ばいです。
葵: しかもこのWNISRの太陽光の数字は比較的控えめな推定で、IEA PVPSの最近のデータでは2025年の太陽光新設は690ギロワットに達したとされ、レポートで使われた数字より180ギロワット多い。つまり太陽光と原子力の差は、報告よりもさらに広いということです。
悠真: Schneider氏のコメントが示唆的でした。「地上での原子力産業の現実は、繁栄するセクターを期待した人にとっては、かなり覚悟がいるものだ」と。米国の原子力企業Holtecは計画していた株式上場の直前、初上場を保留にしました。10億ドル近くを調達しようとしていたものです。同業のFermiは2025年10月の上場から株価の80%を失っています。理由は、地上に投資家を引き留める成果がほとんどないことだそうです。一方で世界の稼働中原子力艦隊は発電量を1.1%増やしましたが、中国以外では減っています。
葵: コメント欄での議論はもっと多面的でした。まずgustavusさんが、「20年以上にわたりほぼ狂信的なレベルで太陽光を推進した政府が世界中にあったにもかかわらず、30年以上新しい原子力発電所がほとんど建設されていなくて、それでやっと太陽光がやっと原子力を追い越すのか?」と、XKCDの対数スケールのコミックを引用して皮肉を言いました。
悠真: そこへの反論が複数ありました。jkahrs595さんは、20年間の「狂信的な」実装という言葉は記事の統計にサポートされていないと指摘し、記事の引用文をそのまま紹介しました。つまり太陽光容量は510ギロワット増、前年比27%増と。tdb7893さんも同意見で、「20年前には政府の太陽光推進は狂信的とは呼べない。太陽光の成長は非常に最近のもので、しかも非常に速く成長している。世界の太陽光の大部分はこの5年間だ」と。maxericksonさんはそのデータのリンクを示しました。
葵: dgacmuさんの解説が最も説得的でした。「それは指数関数的成長のまさに振る舞いだ。最初はゆっくりに見えて、突然追い越す。年間23〜27%の成長率は、本当に動き始めるのに時間がかかる」と。
悠真: そしてtempest_さんが、この対比をより技術的に、かつ冷静に捉えました。中国は原子力を大量に建設中で、彼のカナダの州でも原子力の拡張を計画中だと。「太陽光は、確立された安定した電力網がない場所で繁栄し、初期投資がはるかに低い。2つの異なる道具、異なる用途」と。
葵: それとは別の軸で、景観の議論もありました。trophycaseさんが「太陽光がどれほど醜いか。何マイルも何マイルもの美しく静かな砂漠が台無しになる。環境上の悲劇だ」と。ape4さんが「すべての要素を見ていない。太陽光が何を置き換えているかを見れば、私は美しいと思う」と。
悠真: toomuchtodoさんが、このテーマを一番体系的に掘り下げました。発電用太陽光PVは砂漠を回復させる。農業との併用、つまりアグリボルティックスと相性が良い、と。「美は見る者の目の中にある」という意味で、砂漠が美しいと思うならそうでもいいが、彼にとっては、数十年間確実に低炭素の電力を生み続け、害を与えず、むしろ周囲に恩恵を与える可能性すらある、追加の入力を必要としない固体のハードウェアこそ信じられないほど美しいと。「シンプルさこそ究極の洗練だ」というダ・ヴィンチの言葉まで引用しました。中国のグレートソーラーウォールのニュースリンクと、砂漠の太陽光発電所が電力、収入、生態系を三重に向上させるとするネイチャーの記事、そしてアグリボルティックスのWikipediaへのリンクを添えていました。
葵: そしてhappytoexplainさんが、XKCDのコミックの内容そのものに、技術的に一つ触れました。私は主に原子力派だが、コミックは面白い。ただ、砂糖、石炭、脂肪、ガソリンから酸化によってエネルギーを取り出すのに対し、ウランからは核分裂で取り出す。つまりコミックが示しているより関連する変数は、燃料の中のエネルギー量ではなく、化学プロセスか核プロセスかだ。その比較は、かなり一筋縄ではいかない、と。vlovich123さんが一言、それ以外の材料で核分裂を動かせる見込みはない、と返しています。
悠真: ここまで、技術とAIと経済の流れでしたが、ここで重い話題に移ります。Le Mondeの記事です。ヨルダ川西岸のタイベ村で、ヨーロッパの外交官の車列がイスラエルの入植者に攻撃され、フランスの市長が殴られました。
葵: 記事によると、10月17日の土曜日、フランス、ベルギー、ポーランドのミッションの車が、占領下の西岸のタイベ、主にキリスト教徒の村を訪問するために外交官を運んでいたところ、入植者が降りてきて、パレスチナ人がオリーブを収穫するのを止めようとした、と目撃者たちが述べています。
悠真: 事件の詳細は、覆面をした入植者たちが外交官に向け攻撃的な発言をした後、78歳のBernard Baudoux、フランス北部Aulnoye-Aymeriesの左派市長を蹴った、と目撃者と外交官が確認したということです。彼と話した2人は、怪我をしたが病院には行く必要がなかったと述べています。
葵: そして、Baudoux市長自身の言葉が重要です。攻撃された後、「入植者がこのように振る舞っているなら、イスラエル政府による容認があると思う」と述べました。
悠真: この記事が記事になった理由そのものに、ciconiaさんが鋭い指摘をしています。「これは孤立した事件ではなく、被害者がヨーロッパの要人だからこそ、このストーリーがニュースに届いた」と。そして彼はこの種の事件をpogrom、つまりポグロムという言葉で呼び、別の言葉で表現するのは難しいと。西岸の農村部のパレスチナ人に対して、このような攻撃が毎日、複数回起きており、その規模から見て、単なる無作為の暴力ではなく、農村のパレスチナ人を民族的に浄化するための調整されたキャンペーンだと見られる、と。
葵: この指摘に対してmschuster91さんが、「これは選挙運動だ。それ以外の何ものでもない」と一言。そしてこのスレッドの開始者であるmichaelhillaertさんは、冒頭の一文「Im」だけで切り、vcryanさんは「世界はイスラエルのテロに目を閉じている」と述べました。
悠真: そしてmschuster91さんがもう一つコメントを出していて、これはmetaな指摘です。「率直に言って、それは話題から外れている。このスレッド全体は炎上戦争以外の何ものにもならない」と。実際、このスレッドはコメント数が少なく、発展せずに終わっています。ただ、指摘された問題、つまりオリーブの収穫期の暴力と、それがパレスチナ人に日常的に降りかかるという主張は、解決されていないまま残りました。
葵: 検証されていない点がいくつかあります。まず、この事件の正確な実害と、イスラエル政府の実際の関与、あるいは黙認の度合い。そしてciconiaさんが主張する「毎日複数回の攻撃」という頻度についても、独立のデータ検証が必要です。
悠真: 重い話題が続きましたので、ここから人間味のある、しかし bureaucracy、つまり官僚制の話に移りましょう。Derek Wessmanさんという方が「私は日本の市民になりました」という記事を書いて、多くの反応を集めました。
葵: 彼は2012年、法務局に行ったついでに、帰化を始めようと思い立ったそうです。長いこと考えていたことでした。帰化を扱う部署に入ると、老MOJ官僚が親切に、初回の相談に応じてくれた。初回相談は普通予約が必要ですが、彼は対応してくれた。ただ、今日ではこれは起きないそうです。今は帰化申請がずっと多いと。
悠真: そして彼の文章の核心は、日本政府が意図的に、帰化のプロセスを不透明にし、大量の書類を要求し、最低1年を要し、結果を部分的に主観的判断に依存するように設計している、という描写です。
葵: 書類のリストが圧巻なんですよ。順番に覚えが曖昧だとしても、後から自分が作らされたスプレッドシートを参照して列挙しています。まず、両親6人の兄弟姉妹の出生証明書の原本。両親の婚姻の証明の原本。母が自分を産んだことを証明する、母が署名し日付を入れた誓約書。妻の家族のリスト、氏名、生年月日、国籍、そして自分との現在の関係の状態。そして上記の各人が、同時に帰化を望むか、自分の帰化に同意するか、反対するかについての陳述。
悠真: 自分の出生証明書の原本。婚姻の証明。住んだことのあるすべての住所のリストと、そこに住み始めた日と出た日。学歴の完全な履歴、幼稚園から。その学歴で取得したすべての卒業証書や学位。職務履歴の完全なリスト、会社名、職位、入社日と退職日。
葵: そして翻訳の話が面白いです。英語で発行された文書は、すべて原本と日本語訳を、翻訳の正確性の証明書とともに提出しなければならない。日本語訳にはアルファベット文字を含めてはならず、漢字、ひらがな、カタカタカ、アラビア数字のみ。「漢数字が要求されなかったことだけは感謝すべきだろう」と自嘲気味に書いています。でもすべての固有名詞は、一番ぎこちない形のカタカナで書くんですと。
悠真: さらに、日本で発行された文書はすべて原本とコピー1部ずつ。住民票、在留カード、運転免許証。自分と妻の所得税の還付申告の全年度分、いくつかの年度だったかは思い出せないと。源泉徴収票、国税庁、東京、そして八王子のそれぞれへの税の納付証明。健康保険料の納付証明。年金事務所が発行した、雇用保険の納付証明。そして、これらすべてが、納めたかだけでなく、納めたタイミングが正確だったかを評価される、と。
葵: 会社を運営していた場合はさらに。同じ年度数分の財務諸表、法人税の納付証明、消費税の納付証明、都道府県税の納付証明、市税の納付証明、源泉徴収された従業員の税の納付証明、雇用保険の納付証明。会社登記、定款、顧客リスト、事業内容と将来展望の説明。
悠真: 妻の戸籍。妻が、自分たちが結婚し、子どもを持ったことを確認する陳述。妻が、自分の帰化に同意するか、反対するかを示す陳述。別々の機会に撮影した、家族が一緒に写った写真3枚。
葵: そして、 gcanyon さんの反応が一番共感を呼んだと思います。「過去に住んだことのあるすべての住所と日付。よし、日本はリストから消した。私はどのような状況でもその住所リストを作れない」と。
悠真: ここから読者のアドバイスと、他国の比較が広がります。Qazpqazさんは実用的で、「今からそのリストを付け始めるのをお勧めする。私には何度か助けになった」と。jacquesmさんは冷めていて、「そのデータを必要とする何かは、そもそも私には不要だ。それに、彼らは最初から信じないだろう」と。
葵: NolFさんは、オーストラリアでは一般的に少なくとも10年はかかるものがあると。sonar_unさんの指摘は一番実務的で、投稿の冒頭で止まってしまったと言います。彼が6年間ずっと待ってから帰化を始めた、つまり6年を飛ばした、と説明していたことと、彼が永住者カードを持ったことがなく、更新されるビザだけで生活していて、それが奇妙に思われたと言っていること。
悠真: sonar_unさんの判断は、「それは奇妙だ。彼が帰化に必要と言っていた多くのものは、日本での永住者権の段階で、どの国でもそうであるように、通常は済ませられているはずのものだ」ということです。
葵: ここでkliptさんが出したのが、日本の制度の詳細です。日本は永住権には10年の居住を要求するが、帰化には5年の居住で足りると思っていた。もしそうなら、多くの人が永住権を取る前に帰化するのは驚くことではない、と。それに対してrootsudoさんが一言、「もうそうではない」と。
悠真: さらに charlieyu1 さんが、日本に限らず、住み慣れた国ではステータスをあまり気にされない現実を語りました。英国にしばらく住んでいれば、日常生活では住所と運転免許証があればだいたい何でもできると。「書類をわざわざしなくても大丈夫だろうという感覚が湧く。それがこの20〜50年での物事の進み方だ」と。
葵: そこにGalaxyNovaさんが一言、「それは…本当に良くない」と。tene80iさんが反対側に立って、「どういう意味?英国の大手雇用者は、働かせるためにそれ以上を要求する」と。elmer2さんは実体験から、charlieyu1さんの主張は正しくないと反論しました。英国にほぼ10年間不法に住んでいた人を知っている。彼が得られたのは、政府に何も報告しないひどいレストランの仕事だけだった。入国管理局が何度も来た。移民弁護士を雇っても市民権にはつながらなかった。最終的にうまくいったのは、子どもを持って市民と結婚することだった、と。
悠真: Wessman氏自身も、この記事にオンライン上の反応があったことを認めていて、見覚えのある親切なコメントへの感謝を書いています。そして、帰化を考えている人には、地元の法務局に相談し、法務局が言うことに従うよう、このランダムなグリンゴのブログのようなネット上の場所で読む情報ではなく、促しています。要求される書類リストは威圧的だが、あなたのケースは誰とも同じではない。彼らは個々の申請を別々に扱う。馬の口、つまり一次情報は、私ではなく司法省だ、と。
葵: さて、重くて込み入った話題の後は、息抜きです。今日の最後のトピックに移りますが、これは本当に素敵な投稿でした。Show HNで「高品質のダック、つまりアヒルの音声シンセサイザ」という、celphaseさんによる「The Duck Pond」です。
悠真: ページの内容を説明しますと、小さなマガモの群れが池で一日を過ごしている。3羽のメス、2羽のオス、そして2群れのヒナ。録音は一切使われていません。すべてのquack、つまりガーガーという鳴き声は、その場で合成され、聞く人が岸のどこに立っているかに応じて聞こえます。ヘッドホンを使うモードがあり、5メートル、10メートル、20メートル、40メートル地点にリング、つまり音の聞こえ方が変化するポイントがあります。スペースキーで一時停止、pキーで pea、つまり豆を投げるモードに切り替えられます。
葵: 反応は、「beautiful」が標準で、Hugsboxさんの「これは愛おしい。ありがとう」、yhjc2692さんの「これはfreaking awesome」、bigtechさんの「ついに!」、chimneychangaさんの「楽しかった、ありがとう」、setnoneさんの「私もこれが非常に高品質であることを確認します」と。
悠真: ここで面白い展開があったのは、豆を投げるという仕様から、餌付けの話題に自然に広がったことです。dvhさんが、パンがアヒルに良くないという考えが、自分の釣り場を壊してしまったという経験談を語りました。パンをアヒルに与える場所があって、フライフィッシングに最高の場所だった。コイ、チャブ、ギンブナ、ローチ、さらにナーゼスまで、すべてドライフライで釣れていた。それから、誰かがパンはアヒルに有害だと看板を出した。人々は餌付けを止め、しばらくしてすべての魚が消えた、と。
葵: RonanSolearte さんが一言返して、「それは依然としてアヒルには悪い」と。そして vinckr さんが、パンが悪い理由を体系的に説明してくれました。パンは栄養価が低いこと。特に米国で一般的な白いパンのようなものは。パンが彼らの胃をすぐ満たすので、本来食べるべきものを餌として探さなくなること。一箇所にパンを投げ続けると、過密が起きる、dvhさんの素晴らしい釣り場で起きたことと同じ。動物にストレスを与えること。彼らは一箇所で大量に排泄するので、たくさんの問題が起きること。食べ残しのパンは藻の増殖を引き起こし、それが病気や害虫につながること。最後に、「このアプリのように pea、つまり豆を与えるのが最善。あるいは冷凍のブドウを切ったものも良いと聞いた」と。
葵: tamimioさんは実用的な代替案を提供していて、地元のペットショップで野生鳥用のシード、つまり種を買って与えられると。whartungさんは、公園の湖でアヒルに餌をやっていた思い出を語っています。地元の tack and feed store、馬具と飼料の店で鶏用の餌を買っていた。何十羽もいて、驚いて一斉に飛び始めると、風が目立った、という表現が妙に叙情的で。最終的に公園は餌付けを止める看板を出し、ベンチを撤去したそうです。
悠真: そしてLewisOrtonさんの一言が締めくくりにふさわしい。「アンドロイドは電子のアヒルに餌をやるのか」と、フィリップ・K・ディックの題名のもじり。そして「ちなみに、これはホワイトノイズとして非常によく機能することを見つけた」と。
葵: ここまで12の話題を振り返ってきましたが、改めて繋がりを見ると、テーマは一つでした。
悠真: そう、「変化」です。モデルが変わる、開発の作法が変わる、標準が消える、エネルギーの骨格が変わる、通貨の役割が変わる、そして国境を越えた人間の移動の仕方も変わる。
葵: 今日の話で最も印象的だったのは、皆さんがコメント欄で示した「検証する姿勢」でした。金の輸出の記事への厳しいチェック、Peleのベンチマークへの疑問、OpenCodeの事件への冷静な分析、そして帰化の話での制度の詳細への指摘。
悠真: すべての数字と主張に、どこから来たかと、誰が言っているかを問う。それが今日のスレッド全体に流れていた空気でした。
葵: それでは、今日はこの辺で。ありがとうございました。
悠真: 悠真でした。また次回。